وقتی یک صفحه HTML را در مرورگر باز میکنید، تگها همانطور که در کد نوشته شدهاند نمایش داده نمیشوند. مرورگر ابتدا کد را پردازش میکند، ساختاری به نام DOM میسازد و سپس اطلاعات لازم را برای نمایش محتوای صفحه به کار میگیرد.
اما این فرایند دقیقاً چگونه انجام میشود؟ چرا ساختاری که در ابزار Inspect میبینید ممکن است با کد اولیه HTML متفاوت باشد و CSS و JavaScript چه تأثیری بر نتیجه دارند؟
در این آموزش، مسیر پردازش HTML را از کد منبع تا نمایش صفحه دنبال میکنیم. در پایان نیز با استفاده از Chrome DevTools و یک مثال عملی، تفاوت HTML Source و DOM را بررسی خواهید کرد.
وقتی مرورگر یک صفحه HTML را باز میکند، چه اتفاقی میافتد؟
وقتی یک فایل HTML را در مرورگر باز میکنید، مرورگر فقط محتوای فایل را نمیخواند تا همان کدها را روی صفحه نشان دهد. ابتدا کد HTML را پردازش میکند، از عناصر آن یک ساختار داخلی میسازد و سپس با درنظرگرفتن اطلاعات مربوط به نمایش، محتوای صفحه را به شکل قابلمشاهده درمیآورد.
اگر هنوز با نقش تگها و عناصر آشنا نیستید، ابتدا راهنمای مبانی HTML را بخوانید.
برای مثال، فرض کنید عبارت زیر را در یک فایل HTML نوشتهاید:
<h1>سلام، بیتآموز!</h1>
مرورگر بهجای نمایش تگهای آغاز و پایان، عبارت «سلام، بیتآموز!» را بهعنوان یک عنوان نشان میدهد. اما مرورگر از کجا میفهمد این متن عنوان است و چگونه آن را به خروجی قابلمشاهده تبدیل میکند؟
برای پاسخ، باید چهار مرحله اصلی پردازش صفحه را بشناسیم:
- دریافت کد HTML: اگر آدرس یک وبسایت را باز کنید، مرورگر درخواست دریافت سند را ارسال میکند و سرور در پاسخ، محتوای HTML را برمیگرداند. اگر فایل HTML روی کامپیوترتان باشد، مرورگر میتواند آن را مستقیماً از حافظه دستگاه بخواند. در هر دو حالت، برای پردازش صفحه به محتوای سند نیاز دارد.
- تجزیه HTML و ساخت DOM: مرورگر با استفاده از بخشی به نام HTML Parser، کد دریافتشده را تجزیه میکند و ساختاری درختی به نام DOM یا Document Object Model میسازد. این ساختار مشخص میکند چه عناصری در سند وجود دارند و چه ارتباطی با یکدیگر دارند. DOM صرفاً تصویر صفحه نیست؛ نمایشی ساختاریافته از سند در حافظه مرورگر است.
- پردازش منابع مرتبط با صفحه: مرورگر هنگام خواندن HTML ممکن است با ارجاع به فایلهای CSS، کدهای JavaScript یا تصاویری روبهرو شود که باید دریافت و پردازش شوند. CSS در تعیین ظاهر و چیدمان عناصر نقش دارد و JavaScript میتواند محتوا یا ساختار صفحه را تغییر دهد. البته برای نمایش یک سند HTML ساده، وجود فایل CSS یا JavaScript اختصاصی ضروری نیست.
- ساخت و نمایش خروجی بصری: مرورگر با استفاده از ساختار سند و اطلاعات مربوط به سبکها، مشخص میکند کدام محتوا باید نمایش داده شود و اجزای قابلنمایش چه اندازه و جایگاهی داشته باشند. سپس مراحل ترسیم را انجام میدهد تا نتیجه روی صفحه دیده شود. این فرایند بهطور کلی Rendering یا رندرینگ نام دارد.
بنابراین، بازکردن یک صفحه HTML فقط خواندن یک فایل نیست؛ فرایند تبدیل کد منبع به ساختاری قابلپردازش و سپس خروجی قابلنمایش است. برای درک دقیقتر این تبدیل، باید ببینیم HTML Parser چگونه کدها را میخواند و درخت DOM را میسازد.
مرورگر چگونه HTML را تجزیه و درخت DOM را میسازد؟
مرورگر برای درک محتوای HTML باید کدهای دریافتشده را به ساختاری تبدیل کند که بتواند با آن کار کند. این وظیفه بر عهده HTML Parser است؛ بخشی از مرورگر که کد HTML را بر اساس قواعد مشخصی تجزیه میکند و از آن درختی به نام DOM میسازد.
برای درک این فرایند، باید دو اتفاق را از هم تشخیص دهیم: ابتدا مرورگر اجزای کد HTML را شناسایی میکند و سپس بر اساس آنها، ساختار درختی سند را شکل میدهد.
HTML Parser چگونه کد را پردازش میکند؟
HTML Parser بخشی از موتور مرورگر است که کد HTML را میخواند و ساختار سند را از روی آن میسازد. این فرایند دو بخش اصلی دارد: Tokenization (تبدیل ورودی به توکن) و Tree Construction (ساخت درخت). (قواعد تجزیه HTML در استاندارد WHATWG)
در مرحله Tokenization، مرورگر کاراکترهای کد HTML را بررسی میکند و نشانههای معناداری مانند تگ آغازین، تگ پایانی و کاراکترهای متن را تشخیص میدهد. اطلاعات مربوط به اتریبیوتها نیز همراه تگهای آغازین پردازش میشوند. به این نشانهها Token یا توکن میگویند.
برای مثال، کد زیر را در نظر بگیرید:
<!DOCTYPE html>
<html lang="fa">
<head>
<title>نمونه DOM</title>
</head>
<body>
<p>یادگیری <strong>HTML</strong> سادهتر میشود.</p>
</body>
</html>
وقتی Parser به تگ آغازین <p> میرسد، آن را بهعنوان نشانه شروع یک عنصر پاراگراف شناسایی میکند. متن «یادگیری» نیز بهعنوان محتوای متنی پردازش میشود. سپس با رسیدن به <strong>، شروع یک عنصر جدید درون پاراگراف تشخیص داده میشود.
اما شناسایی توکنها بهتنهایی کافی نیست. مرورگر باید بداند هر عنصر در کجای سند قرار دارد و چه عناصری داخل آن هستند.
اینجاست که بخش Tree Construction وارد عمل میشود. این بخش توکنهای تولیدشده را بر اساس قواعد تجزیه HTML پردازش میکند و با ایجاد عناصر و گرههای متنی، درخت سند را شکل میدهد.
این دو بخش در جریان پردازش با یکدیگر کار میکنند؛ یعنی مرورگر لازم نیست ابتدا تمام کد HTML را به توکن تبدیل کند و بعد ساخت درخت را شروع کند. با پردازش توکنها، ساختار DOM نیز بهتدریج شکل میگیرد.
عناصر HTML چگونه به گرههای درخت DOM تبدیل میشوند؟
DOM مخفف Document Object Model و به معنی «مدل شیءگرای سند» است. در این مدل، مرورگر سند HTML را بهصورت مجموعهای از گرهها (Node) نگهداری میکند که ارتباط آنها ساختاری درختی دارد.
برای نمونه، در کد قبلی، عنصر <body> شامل یک پاراگراف است و عنصر <strong> داخل همان پاراگراف قرار دارد. این ارتباط در DOM نیز حفظ میشود.
نمای سادهشده درخت DOM آن کد به شکل زیر است:
Document
└── html (lang=”fa”)
├── head
│ └── title
│ └── #text “نمونه DOM”
└── body
└── p
├── #text “یادگیری “
├── strong
│ └── #text “HTML”
└── #text ” سادهتر میشود.”
در این نمایش، برای خوانایی، گره DOCTYPE و گرههای متنی مربوط به فاصلهها و شکست سطرهای کد نشان داده نشدهاند.
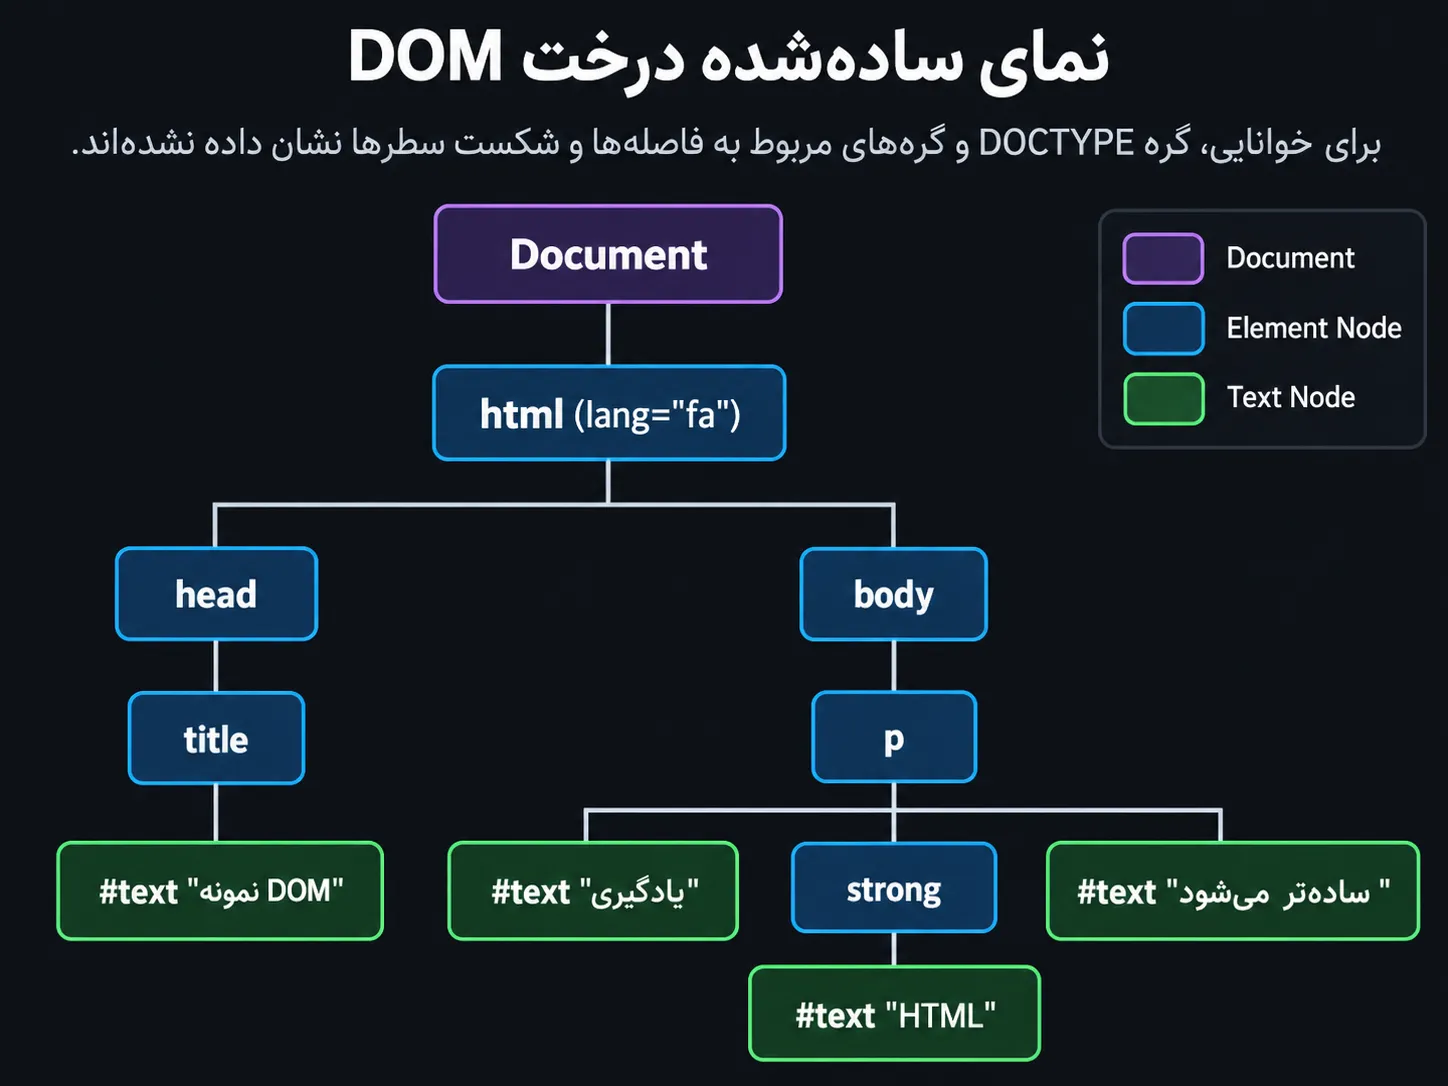
چند نکته در این ساختار اهمیت دارد:
- Document: گره اصلی سند است که ساختار DOM به آن تعلق دارد.
- Element Node: گرهای است که یک عنصر HTML مانند html، body، p یا strong را نمایش میدهد.
- Text Node: گرهای است که متن موجود در سند را نگهداری میکند؛ به همین دلیل عبارت «HTML» درون عنصر strong یک گره متنی جداگانه دارد.
ارتباط میان گرهها نیز اهمیت دارد. برای مثال، body والد (Parent) عنصر p است و p فرزند (Child) آن محسوب میشود. عنصر strong هم فرزند p است. به این ترتیب، مرورگر فقط فهرستی از عناصر ندارد؛ بلکه جایگاه و ارتباط آنها را نیز میشناسد.
دقت کنید که هر گره DOM الزاماً یک تگ HTML نیست. متنها و کامنتها نیز میتوانند گره داشته باشند. از طرف دیگر، اتریبیوتی مانند lang=”fa” مشخصه عنصر html است و در این درخت بهصورت فرزند مستقل آن نمایش داده نمیشود.
حاصل این فرایند، ساختاری است که مرورگر و JavaScript میتوانند به عناصر و محتوای آن دسترسی داشته باشند. بااینحال، DOM همیشه کپی دقیق و بدون تغییر کد HTML اولیه نیست. قواعد HTML Parser میتوانند روی ساختار نهایی اثر بگذارند و JavaScript نیز میتواند پس از ساختهشدن گرهها، آنها را تغییر دهد. تفاوت این دو وضعیت را در بخش بعدی بررسی میکنیم.
تفاوت HTML Source و DOM چیست؟
HTML Source کد اولیهای است که مرورگر از سرور دریافت میکند یا از یک فایل محلی میخواند؛ اما DOM ساختار سندی است که مرورگر از پردازش آن کد میسازد و میتواند در طول اجرای صفحه تغییر کند.
این دو معمولاً شباهت زیادی به یکدیگر دارند، اما لزوماً یکسان نیستند. ممکن است عنصری در DOM وجود داشته باشد که تگ آن را مستقیماً در کد اولیه ننوشته باشید، یا متنی در صفحه ببینید که با متن موجود در Source متفاوت است.
برای درک این تفاوت، باید دو عامل را بشناسیم: قواعد HTML Parser هنگام ساخت سند و تغییراتی که JavaScript میتواند روی DOM اعمال کند.
چرا ساختار DOM ممکن است با کد اولیه متفاوت باشد؟
هنگام ساخت DOM، مرورگر فقط تگهای موجود در HTML Source را به همان ترتیب کپی نمیکند. HTML Parser بر اساس قواعد استاندارد HTML تصمیم میگیرد گرههای سند چگونه ساخته و در چه جایگاهی قرار داده شوند. به همین دلیل، ساختار نهایی ممکن است با چیزی که مستقیماً در کد نوشتهاید تفاوت داشته باشد.
یکی از نمونههای روشن این رفتار را میتوان در جدولهای HTML مشاهده کرد.
فرض کنید کد زیر در سند شما وجود دارد:
					<table>
  <tr>
    <td>HTML</td>
  </tr>
</table>
در این کد، تگ tr مستقیماً داخل table نوشته شده و هیچ تگ tbody وجود ندارد.
بااینحال، هنگامی که مرورگر این کد را بهعنوان HTML تجزیه میکند، ساختار مربوط به جدول در DOM به شکل زیر خواهد بود:
					<table>
  <tbody>
    <tr>
      <td>HTML</td>
    </tr>
  </tbody>
</table>
در اینجا مرورگر عنصر tbody را هنگام ساخت DOM ایجاد کرده است؛ با اینکه تگ آن در HTML Source نوشته نشده بود.
بنابراین، هر تفاوتی میان Source و DOM نشانه وجود خطا نیست. برخی تفاوتها نتیجه طبیعی قواعد تجزیه HTML هستند. در شرایط دیگر نیز اگر عناصر بهشکل نامعتبر تودرتو قرار گرفته باشند، Parser ممکن است هنگام ساخت درخت، ساختاری متفاوت از ترتیب ظاهری تگها ایجاد کند. برای شناسایی خطاهای قابلتشخیص در کد منبع، میتوانید از ابزار «اعتبارسنج HTML بیتآموز» استفاده کنید؛ این ابزار DOM نهایی پس از اجرای JavaScript را بررسی نمیکند.
برای فهمیدن اینکه مرورگر واقعاً چه ساختاری ساخته است، باید DOM را بررسی کنیم، نه اینکه فقط به متن فایل HTML تکیه کنیم.
JavaScript چگونه میتواند DOM را تغییر دهد؟
تفاوت HTML Source و DOM فقط به عملکرد Parser محدود نمیشود. پس از ایجاد گرههای DOM، کد JavaScript نیز میتواند به آنها دسترسی پیدا کند و تغییرشان دهد.
برای مثال، کد زیر را در نظر بگیرید:
					<p id="message">متن اولیه</p>

<script> document.getElementById("message").textContent = "متن جدید";</script>
در این مثال، ابتدا یک پاراگراف با متن «متن اولیه» در HTML تعریف شده است.
سپس JavaScript با استفاده از document.getElementById(“message”) عنصر دارای شناسه message را پیدا میکند و با تغییر ویژگی textContent، محتوای متنی آن را جایگزین میکند.
اگر این کد در شرایط معمول اجرا شود، متن قابلمشاهده پاراگراف به «متن جدید» تغییر میکند و نمایش HTML متناظر با وضعیت جدید آن در DOM چنین خواهد بود:
<p id="message">متن جدید</p>
اما اگر HTML Source را مشاهده کنید، همچنان متن اولیه در کد سند وجود دارد؛ زیرا این دستور JavaScript گره متنی DOM را تغییر داده است، نه محتوای فایل اصلی را.
JavaScript علاوه بر تغییر متن، میتواند عناصر جدید بسازد، عناصر موجود را حذف کند، جایگاه آنها را تغییر دهد یا اتریبیوتهایشان را اصلاح کند. به همین دلیل، DOM یک ساختار ثابت و تغییرناپذیر نیست.
البته هر تغییری که در ظاهر صفحه مشاهده میکنید، لزوماً به معنی تغییر DOM نیست. برای مثال، CSS میتواند رنگ یا اندازه یک عنصر را تغییر دهد، بدون اینکه محتوای HTML یا ساختار گرههای DOM عوض شود.
در نتیجه، برای مشاهده کد اولیه سند میتوان از View Page Source استفاده کرد؛ اما برای بررسی ساختار فعلی DOM باید سراغ ابزار توسعهدهنده مرورگر، مانند پنل Elements در Chrome، رفت.
این تفاوت بهویژه هنگام بررسی صفحاتی اهمیت پیدا میکند که JavaScript محتوای آنها را تغییر میدهد. در چنین صفحاتی، دانستن اینکه کدام محتوا در HTML اولیه وجود داشته و کدام بخش بعداً به DOM اضافه شده یا تغییر کرده است، به درک رفتار صفحه کمک میکند.
CSS و JavaScript چه نقشی در نمایش صفحه دارند؟
ساختهشدن DOM به این معنی نیست که مرورگر میتواند بلافاصله ظاهر نهایی صفحه را نمایش دهد. DOM ساختار و محتوای سند را مشخص میکند، اما مرورگر برای نمایش عناصر باید بداند هرکدام چه ظاهری دارند، کجا قرار میگیرند و چه فضایی اشغال میکنند.
اینجاست که CSS و JavaScript نقش پیدا میکنند. CSS ظاهر و چیدمان عناصر را تعیین میکند و JavaScript میتواند محتوا، ساختار یا سبکهای صفحه را تغییر دهد. مرورگر برای تبدیل این اطلاعات به خروجی بصری، فرایندی به نام Rendering را انجام میدهد.
البته JavaScript برای نمایش همه صفحات ضروری نیست. حتی اگر هیچ کد CSS یا JavaScript اختصاصی ننویسید، مرورگر با استفاده از سبکهای پیشفرض خود میتواند محتوای یک سند HTML ساده را نمایش دهد.
CSSOM و Render Tree چه هستند؟
همانطور که مرورگر کد HTML را تجزیه میکند و DOM را میسازد، کدهای CSS را نیز پردازش میکند. نتیجه این پردازش ساختاری به نام CSSOM یا CSS Object Model است که قواعد سبکدهی را در اختیار مرورگر قرار میدهد. (نحوه ساخت CSSOM در مستندات MDN)
برای مثال، کد زیر را در نظر بگیرید:
<style> .message { color: blue; padding: 10px; } .hidden { display: none; }</style>
<p class="message">سلام، بیتآموز!</p>
<p class="hidden">این متن پنهان است.</p>
در این مثال، HTML دو پاراگراف دارد و هر دو در DOM وجود خواهند داشت. اما قواعد CSS مشخص میکنند که متن پاراگراف اول آبی باشد و از اطراف محتوای آن ۱۰ پیکسل فاصله داخلی در نظر گرفته شود. پاراگراف دوم نیز به دلیل داشتن ویژگی display: none در خروجی بصری نمایش داده نمیشود.
مرورگر برای مشخصکردن آنچه باید روی صفحه ترسیم شود، اطلاعات DOM و CSSOM را همراه با قواعد محاسبه سبکها به کار میگیرد و ساختاری برای رندر صفحه ایجاد میکند که در توضیح ساده این فرایند، Render Tree یا درخت رندر نامیده میشود.
تفاوت مهم این دو ساختار در وظیفه آنهاست:
- DOM ساختار سند و ارتباط عناصر را نگهداری میکند؛ حتی عناصری که نمایش داده نمیشوند.
- Render Tree اطلاعات لازم برای نمایش و چیدمان محتوای قابلرندر را در بر میگیرد؛ بنابراین لزوماً شامل تمام گرههای DOM نیست.
برای مثال، پاراگراف دوم در کد بالا همچنان در DOM وجود دارد، اما چون display: none دارد، جعبهای برای نمایش آن در Render Tree ایجاد نمیشود.
این تفاوت به آن معنا نیست که هر عنصر نامرئی از Render Tree حذف میشود. برای نمونه، عنصری با visibility: hidden همچنان میتواند در چیدمان صفحه فضا اشغال کند. بنابراین، حضور یک عنصر در DOM و مشارکت آن در فرایند نمایش، دو موضوع متفاوت هستند.
اگر JavaScript ویژگیها یا کلاسهای یک عنصر را تغییر دهد، ممکن است سبک محاسبهشده آن نیز عوض شود. برای مثال، حذف کلاس hidden از پاراگراف دوم باعث میشود آن عنصر دیگر تحت تأثیر قانون display: none نباشد و بتواند در صفحه نمایش داده شود.
Layout و Paint چگونه خروجی قابلنمایش ایجاد میکنند؟
پس از مشخصشدن اطلاعات لازم برای رندر، مرورگر باید اندازه و موقعیت اجزای صفحه را محاسبه کند. این کار در مرحله Layout (چیدمان) انجام میشود.
در Layout، مرورگر تعیین میکند هر جعبه چه ابعادی داشته باشد و در چه موقعیتی قرار بگیرد. برای مثال، عرض فضای در دسترس، اندازه متن، فاصلههای داخلی و بیرونی و قواعد چیدمان CSS میتوانند روی محل قرارگیری عناصر اثر بگذارند.
فرض کنید یک پاراگراف طولانی در صفحه وجود دارد. اگر عرض پنجره مرورگر کاهش پیدا کند، ممکن است متن در سطرهای بیشتری قرار بگیرد و ارتفاع پاراگراف افزایش یابد. مرورگر برای تعیین اندازه و جایگاه جدید اجزای تحت تأثیر، محاسبات چیدمان را بهروزرسانی میکند.
اما دانستن اندازه و موقعیت عناصر هنوز برای دیدن آنها کافی نیست. مرورگر باید ظاهرشان را نیز ترسیم کند.
در مرحله Paint (ترسیم)، اطلاعاتی مانند رنگ متن، پسزمینه، حاشیه و سایر ویژگیهای بصری برای ترسیم آماده میشوند. در مرورگرهای امروزی، ممکن است محتوای ترسیمشده در لایههای مختلف قرار بگیرد و مرحلهای به نام Compositing نیز برای ترکیب این لایهها انجام شود.
بهصورت ساده، تفاوت دو مرحله چنین است:
- Layout: عنصر کجا قرار میگیرد و چه اندازهای دارد؟
- Paint: ظاهر آن عنصر، مانند متن، رنگ و حاشیه، چگونه ترسیم میشود؟
این مراحل فقط هنگام بازشدن اولیه صفحه اتفاق نمیافتند. اگر JavaScript محتوای صفحه را تغییر دهد یا کاربر اندازه پنجره را عوض کند، مرورگر ممکن است بخشی از محاسبات سبک، چیدمان یا ترسیم را دوباره انجام دهد.
البته هر تغییر ظاهری به اجرای دوباره تمام مراحل نیاز ندارد. برای مثال، تغییر رنگ متن معمولاً به محاسبه مجدد جایگاه عنصر احتیاج ندارد، درحالیکه تغییر عرض آن ممکن است چیدمان را نیز تحت تأثیر قرار دهد.
در نتیجه، نمایش صفحه یک خروجی ثابت و یکباره از HTML نیست. مرورگر میتواند با تغییر DOM، سبکها یا شرایط نمایش، خروجی بصری را بهروزرسانی کند.
اکنون که تفاوت کد اولیه، DOM و فرایند نمایش را میدانیم، میتوانیم با ابزار توسعهدهنده مرورگر، ساختار واقعی یک صفحه را بررسی کنیم و ببینیم عناصر HTML چگونه در DOM قرار گرفتهاند.
چگونه DOM یک صفحه HTML را در DevTools بررسی کنیم؟
برای مشاهده ساختار DOM لازم نیست به کدهای داخلی مرورگر دسترسی داشته باشید. مرورگر Google Chrome ابزاری به نام DevTools (Developer Tools) دارد که به شما اجازه میدهد عناصر صفحه و ارتباط آنها را بررسی کنید.
در این ابزار، پنل Elements ساختار فعلی DOM را نشان میدهد. به همین دلیل میتوانید ببینید مرورگر کدام عناصر را ساخته و آیا ساختار آنها با HTML Source تفاوت دارد یا نه.
در این بخش، ابتدا روش مشاهده DOM را یاد میگیریم و سپس با یک مثال، دو نوع تغییر را بررسی میکنیم: ایجاد یک عنصر توسط HTML Parser و تغییر محتوای یک عنصر توسط JavaScript.
مشاهده ساختار DOM در پنل Elements
برای شروع، یک صفحه HTML را در نسخه دسکتاپ مرورگر Chrome باز کنید. این صفحه میتواند یک وبسایت یا فایل HTML ذخیرهشده روی کامپیوترتان باشد. اگر هنوز فایل HTML نساختهاید، آموزش «ساخت اولین فایل HTML» را دنبال کنید.
سپس مراحل زیر را انجام دهید:
- روی یکی از عناصر صفحه، مانند یک عنوان یا پاراگراف، راستکلیک کنید و گزینه Inspect را انتخاب کنید.
- پنل DevTools باز میشود و معمولاً شما را مستقیماً به بخش Elements میبرد. اگر پنل دیگری نمایش داده شد، تب Elements را انتخاب کنید.
- در قسمت نمایش ساختار DOM، عنصر انتخابشده را پیدا کنید. میتوانید با کلیک روی فلش کنار عناصر، گرههای فرزند آنها را باز کنید.
- برای بررسی ساختار کلی سند، عناصر html، head و body را پیدا کنید و شاخههای مربوط به آنها را گسترش دهید.
در پنل Elements، ساختار صفحه بهصورت تودرتو نمایش داده میشود. برای مثال، اگر یک پاراگراف داخل عنصر body قرار داشته باشد، با بازکردن شاخه body میتوانید آن را مشاهده کنید.
اگر روی یک عنصر در درخت DOM حرکت کنید، Chrome معمولاً محل همان عنصر را در صفحه مشخص میکند. این قابلیت کمک میکند ارتباط میان عناصر موجود در ساختار DOM و محتوای قابلمشاهده صفحه را تشخیص دهید.
راه دیگر بازکردن DevTools استفاده از میانبر Ctrl + Shift + I در ویندوز و لینوکس یا Command + Option + I در مک است.
مقایسه HTML Source با DOM در یک مثال عملی
برای اینکه تفاوت HTML Source و DOM را مستقیماً بررسی کنید، از یک سند کوچک استفاده میکنیم. در این مثال، یک جدول داریم که تگ tbody آن نوشته نشده است و یک پاراگراف که متنش با JavaScript تغییر میکند.
کد زیر را در یک فایل با نام dom-example.html ذخیره کنید:
					<!DOCTYPE html>
<html lang="fa" dir="rtl">
<head>
  <meta charset="UTF-8">
  <title>بررسی DOM</title>
</head>
<body>
  <p id="status">متن اولیه</p>

  <table>
    <tr>
      <td>آموزش HTML</td>
    </tr>
  </table>

  <script> document.getElementById("status").textContent = "متن جدید"; </script>
</body>
</html>
هنگام ذخیره فایل، از پسوند .html و کدگذاری UTF-8 استفاده کنید تا متن فارسی بهدرستی نمایش داده شود.
اکنون فایل را در Chrome باز کنید. در شرایط معمول و با فعالبودن JavaScript، انتظار میرود متن «متن جدید» و عبارت «آموزش HTML» داخل یک خانه جدول روی صفحه دیده شوند.
برای بررسی اتفاقی که پشت صحنه افتاده است، این مراحل را دنبال کنید:
- روی عبارت «متن جدید» راستکلیک کنید و Inspect را بزنید. در پنل Elements، پاراگراف دارای شناسه status را مشاهده کنید.
- بررسی کنید که متن داخل این پاراگراف به «متن جدید» تغییر کرده باشد.
- در همان پنل، شاخه table را باز کنید. انتظار میرود عنصر tbody را میان table و tr ببینید، با اینکه آن را در کد اولیه ننوشتهاید.
- حالا به صفحه برگردید، روی فضای خالی آن راستکلیک کنید و گزینه View page source را انتخاب کنید تا HTML Source را ببینید.
- کد منبع و ساختار مشاهدهشده در Elements را با یکدیگر مقایسه کنید.
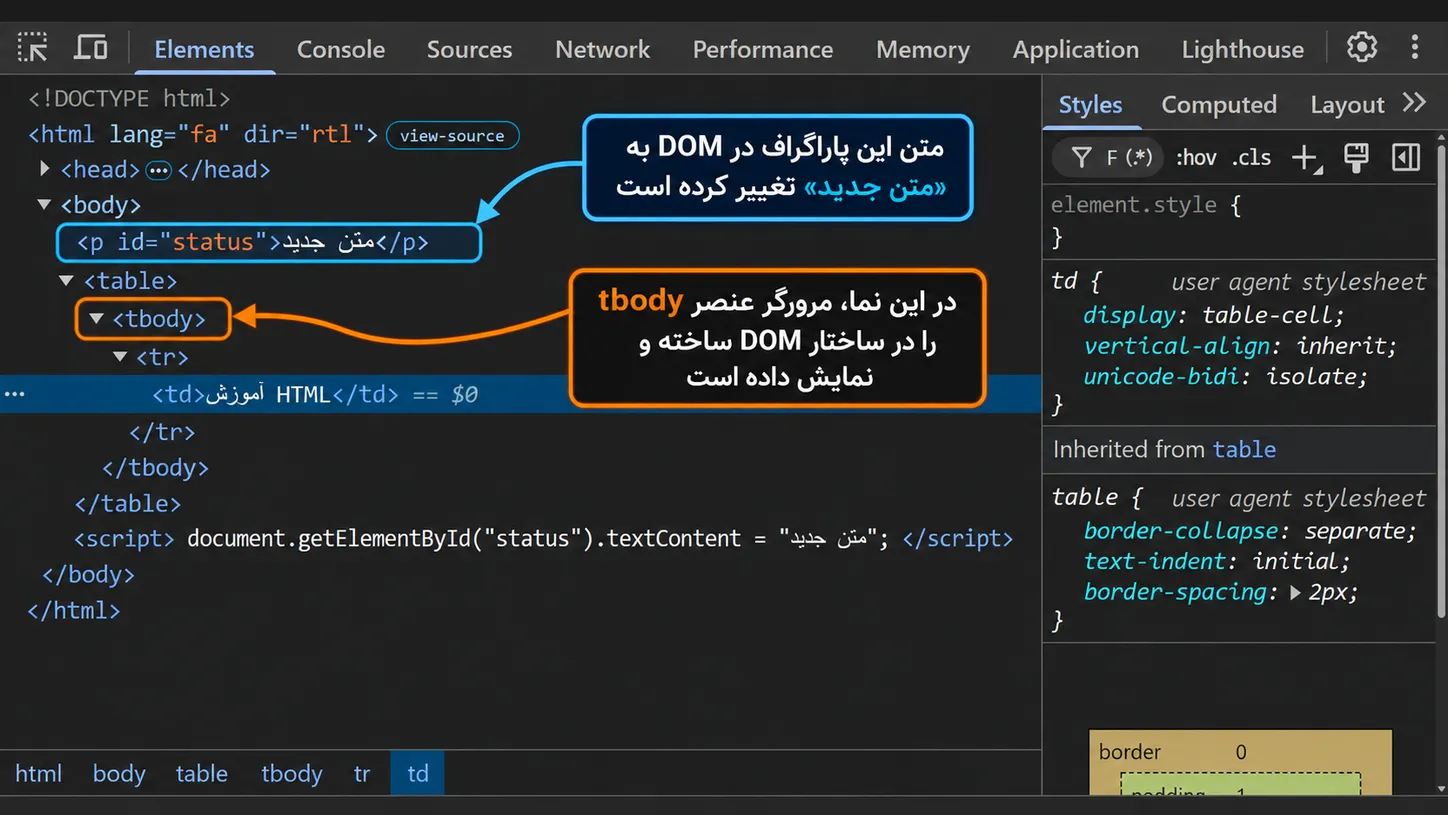
در این مقایسه باید به دو تفاوت مشخص توجه کنید:
تفاوت اول: عنصر tbody
در HTML Source، تگ tr مستقیماً داخل table قرار دارد؛ اما طبق قواعد تجزیه HTML، مرورگر هنگام ساخت DOM یک عنصر tbody میان آنها ایجاد میکند.
بخش مربوط به جدول در DOM باید ساختاری مشابه زیر داشته باشد:
					<table>
  <tbody>
    <tr>
      <td>آموزش HTML</td>
    </tr>
  </tbody>
</table>
تفاوت دوم: محتوای پاراگراف
در HTML Source، متن داخل عنصر p همچنان «متن اولیه» است. بااینحال، پس از اجرای دستور JavaScript، محتوای متنی این عنصر در DOM به «متن جدید» تغییر میکند.
بنابراین، در پنل Elements باید محتوای فعلی پاراگراف را به شکل زیر ببینید:
<p id="status">متن جدید</p>
دقت کنید که نمایش قطعههای بالا برای توضیح خروجی موردانتظار است؛ ممکن است جزئیات قالببندی آنها در DevTools متفاوت باشد.
اگر نتیجه موردانتظار را مشاهده نکردید، ابتدا مطمئن شوید فایل ذخیرهشده را باز کردهاید و در پنل Elements هستید، نه در نمای Source. اگر متن پاراگراف تغییر نکرده است، اجرای JavaScript را نیز بررسی کنید.
این تمرین نشان میدهد که HTML Source نقطه شروع پردازش سند است، اما DOM وضعیت ساختاری سند را در مرورگر نشان میدهد. بعضی تفاوتها هنگام تجزیه HTML ایجاد میشوند و بعضی دیگر نتیجه تغییراتی هستند که JavaScript روی DOM اعمال میکند.
با شناخت این تفاوت، هنگام بررسی یک صفحه وب میتوانید دقیقتر تشخیص دهید چه چیزی در کد اولیه نوشته شده و مرورگر در ساختار فعلی صفحه چه چیزی را نگهداری میکند.
جمعبندی
مرورگر برای نمایش یک صفحه، کد HTML را تجزیه میکند و از آن ساختار DOM را میسازد. سپس با استفاده از اطلاعات مربوط به سبکها و چیدمان، محتوای صفحه را به خروجی قابلنمایش تبدیل میکند. این ساختار میتواند هنگام تجزیه HTML یا اجرای JavaScript تغییر کند؛ به همین دلیل، چیزی که در DOM مشاهده میکنید همیشه دقیقاً همان کد اولیه نیست.
برای اطمینان از درک این فرایند، کافی است یک فایل HTML ساده را در مرورگر باز کنید و ساختار آن را در پنل Elements با کد منبع مقایسه کنید. اگر بتوانید تفاوتهای آنها را تشخیص دهید و علتشان را توضیح دهید، مهمترین هدف این آموزش را به دست آوردهاید.
اگر میخواهید یادگیری HTML را از مفاهیم پایه تا ساختار صفحات، فرمها و عناصر معنایی بهصورت منظم ادامه دهید، میتوانید از دوره HTML بیت آموز استفاده کنید.
سوالات متداول
وقتی با ابزار Inspect متن، اتریبیوت یا ساختار یک عنصر را تغییر میدهید، معمولاً فقط DOM همان صفحه در مرورگر شما تغییر میکند و فایل HTML اصلی دستنخورده باقی میماند. با رفرش صفحه، مرورگر دوباره سند را بارگذاری و DOM را بازسازی میکند؛ به همین دلیل تغییرات موقت از بین میروند. برای دائمیکردن تغییرات باید فایل اصلی را ویرایش کنید یا از امکاناتی مانند Workspaces استفاده کنید.
در Chrome DevTools میتوانید روی عنصر موردنظر در پنل Elements راستکلیک کنید و از منوی Break on، گزینهای مانند Subtree modifications یا Attribute modifications را انتخاب کنید. سپس با اجرای دوباره عملی که باعث تغییر میشود، مرورگر میتواند اجرای JavaScript را در محل تغییر متوقف کند. به این ترتیب، میتوانید کدی را که باعث تغییر گره یا اتریبیوت شده بررسی کنید.
رویداد DOMContentLoaded زمانی اجرا میشود که تجزیه سند HTML کامل شده و اسکریپتهای defer و ماژولهای مرتبط اجرا شده باشند؛ اما برای بارگذاری کامل تصاویر و بعضی منابع دیگر منتظر نمیماند. در مقابل، رویداد load پس از بارگذاری صفحه و منابع وابسته آن، بهجز مواردی مانند منابع بارگذاریشونده بهصورت Lazy، اجرا میشود. بنابراین آمادهشدن DOM لزوماً به معنی بارگذاری کامل تمام منابع صفحه نیست.
اگر JavaScript پیش از ساختهشدن عنصر موردنظر در DOM اجرا شود، دستوری مانند document.getElementById() ممکن است مقدار null برگرداند. این اتفاق میتواند زمانی رخ دهد که اسکریپت زودتر از عنصر HTML اجرا شده باشد. برای جلوگیری از این مشکل، میتوانید اجرای کد را به زمان مناسب موکول کنید؛ مثلاً از defer برای اسکریپت خارجی یا رویداد DOMContentLoaded استفاده کنید.
مرورگر برای نمایش اولیه صفحه همیشه منتظر بارگذاری تمام تصاویر نمیماند. پردازش HTML، دریافت منابع و نمایش محتوا میتوانند تا حدی همزمان پیش بروند. به همین دلیل ممکن است متن صفحه زودتر دیده شود و تصاویر کمی بعد ظاهر شوند. البته بعضی منابع، مانند CSS موردنیاز برای نمایش اولیه یا اسکریپتهای مسدودکننده، میتوانند شروع نمایش را به تأخیر بیندازند.
چقدر این پست مفید بود؟
با یک کلیک، صدای خود را به گوش ما برسانید!
میانگین امتیاز کاربران / 5. تعداد نظر:
اولین باشید! نظر شما اهمیت دارد!
متاسفیم این پست برای شما مفید نبود.
اجازه دهید این پست را بهتر کنیم!
به ما بگویید چگونه میتوانیم بهتر شویم!
هنوز دیدگاهی ثبت نشده است.